EOCRC 실습 5: splicing event에서 신항원 후보까지
1. 무엇을 실습하나
섹션 제목: “1. 무엇을 실습하나”EOCRC 실습 4의 출력은 genomic coordinate와 PSI 차이입니다. 이 실습은 그 좌표를 짧은 peptide 후보로 바꿉니다.
| 단계 | 입력 | 출력 |
|---|---|---|
| 좌표 확장 | 종양에서 증가한 splice region | strand가 있는 BED12 |
| 서열 추출 | BED12와 hg38 FASTA | spliced nucleotide FASTA |
| 번역 | nucleotide sequence | reading frame별 amino-acid sequence |
| peptide 생성 | amino-acid sequence | 겹치는 9-mer 목록 |
| MHC-I 예측 | 9-mer와 HLA allele | binding affinity와 percentile rank |
좌표가 맞아도 reading frame이 틀리면 전혀 다른 peptide가 나옵니다. MHC-I에 잘 결합한다고 예측돼도 그 peptide가 실제 세포에서 만들어지고 제시되며 T세포 반응을 일으킨다는 뜻은 아닙니다.
2. 공개 입력으로 어디까지 진행할 수 있는지 감사한다
섹션 제목: “2. 공개 입력으로 어디까지 진행할 수 있는지 감사한다”원 논문은 EOCRC Tumor 대 Normal에서 유의했던 82개 splice event를 출발점으로 사용했습니다. 종양에서 더 많이 나타난 alternatively spliced region에 양쪽 27 nucleotide를 더하고, bedtools getfasta의 strand와 split 옵션으로 intron을 제외한 서열을 추출했습니다.
Supplementary Table S6의 Location은 82개 모두 파싱되지만, 한 event를 구성하는 인접 exon의 BED12 block은 공개되지 않았습니다. bedtools getfasta -split에는 바로 이 block 구조가 필요합니다. 시작과 끝 좌표만으로 exon block을 추측하면 논문과 다른 nucleotide와 peptide를 만들 수 있으므로 공개 입력만 사용한 실행은 서열 추출 전에 멈춥니다.
실행 프롬프트: neoantigen 입력 완전성 감사
EOCRC 실습 4의 공개 event 표가 서열 추출에 충분한지 감사해줘.

1. outputs/paper-table-s6-82-splicing-events.csv의 Gene name, Location, delta PSI, FDR, Event type을 읽어.
2. Location을 chromosome, strand, start, end로 파싱하고 성공·실패 수를 기록해.
3. delta PSI가 양수인 종양 증가 event를 세고 selection_direction 열에 남겨.
4. 각 event에 BED12의 blockCount, blockSizes, blockStarts 또는 동등한 인접 exon 구조가 있는지 확인해.
5. 정확한 exon block이 없으면 단일 좌표 구간을 exon으로 가정하지 말고 exact_bed12_records=0으로 기록해.
6. 전체 event, 종양 증가 event, 서열 추출로 진행 가능한 exact BED12 record 수를 outputs/neoantigen-input-audit.csv에 저장하고 막대그래프를 만들어.
7. exact BED12 record가 0이면 hg38 다운로드, getfasta, 번역, 9-mer 생성, NetMHCpan 실행을 모두 건너뛰고 빠진 입력을 설명한 뒤 멈춰.
8. 저자 측 rMATS/Whippet 원본 표나 BED12를 확보한 경우에만 아래 조건부 절차로 진행해.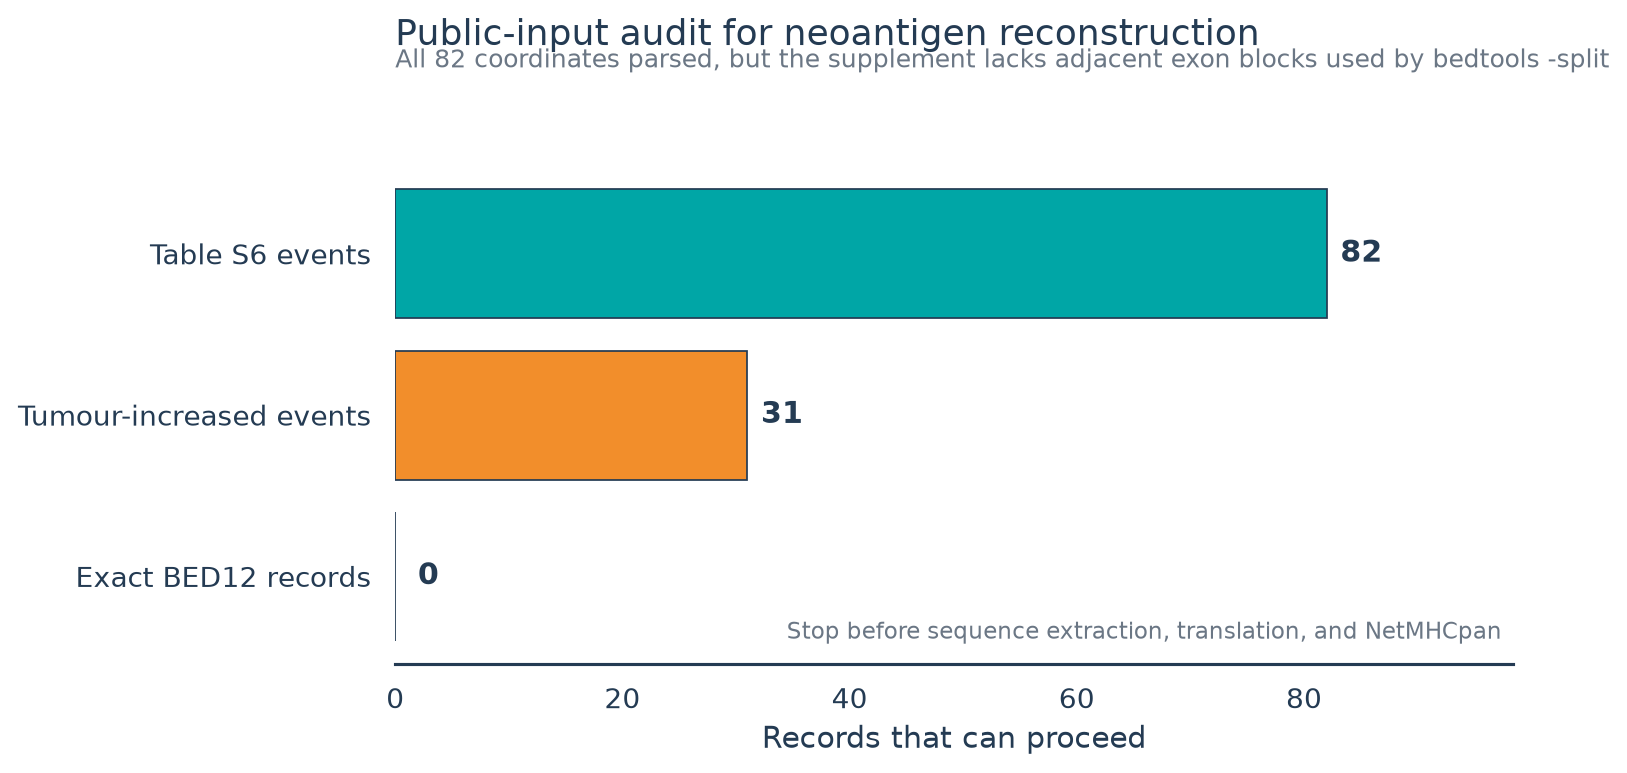
실제 실행 결과: 82개 좌표는 모두 파싱됐고 종양 증가 event는 31개였습니다. 그러나 정확한 BED12 block을 복원할 수 있는 record는 0개여서 서열 추출, 번역, 9-mer 생성과 NetMHCpan 실행 전에 멈췄습니다.
-s를 빠뜨리면 reverse-strand gene에서 반대 방향 서열을 번역하게 됩니다. -split을 빠뜨리면 BED block 사이 intron까지 이어 붙일 수 있습니다. 두 옵션은 단순 편의가 아니라 peptide 서열을 결정하는 조건입니다.
3. BED12가 별도로 있을 때만 세 reading frame과 9-mer를 만든다
섹션 제목: “3. BED12가 별도로 있을 때만 세 reading frame과 9-mer를 만든다”splice-junction 주변의 짧은 genomic sequence만으로 실제 coding frame을 항상 알 수 있는 것은 아닙니다. 원 논문은 EMBOSS transeq로 세 forward reading frame을 번역하고 stop codon이 포함된 amino-acid sequence를 제거했습니다.
2단계 프롬프트: 번역과 9-mer peptide 생성
추출한 nucleotide FASTA를 amino-acid와 9-mer 후보로 변환해줘.

1. EMBOSS transeq가 설치되어 있는지 확인해. 없으면 임의로 설치하지 말고, Biopython으로 같은 세 forward reading frame을 번역하는 대체 구현을 별도 함수로 작성했다고 명시해.
2. event마다 frame 1, 2, 3을 번역하고 nucleotide 길이의 나머지와 번역된 amino-acid 길이를 audit해.
3. stop codon이 포함된 amino-acid sequence를 제외하되 제외한 event와 frame을 outputs/translation-audit.tsv에 남겨.
4. 남은 amino-acid sequence에서 한 칸씩 이동하는 모든 9-mer를 만들고 event ID, gene, frame, peptide_start, peptide, junction_overlap 열을 저장해.
5. splice junction을 실제로 가로지르지 않는 flank-only 9-mer는 별도로 표시해. 종양 특이 junction에서 유래했다는 이유만으로 모든 flank peptide를 종양 특이라고 부르지 마.
6. 중복 peptide는 peptide sequence와 HLA allele 조합 전까지 제거하지 말고, 어느 event에서 왔는지 provenance를 보존해.
7. 결과를 outputs/eocrc-splice-9mers.tsv와 FASTA 형식 outputs/eocrc-splice-9mers.fasta로 저장해.
8. event 수, 유효 frame 수, 전체 9-mer 수, junction-overlap 9-mer 수와 중복 sequence 수를 출력한 뒤 멈춰.
정확한 transcript CDS frame을 알 수 있다면 세 frame을 모두 후보로 두는 것보다 해당 frame을 사용하는 편이 낫습니다. 이 실습은 논문 절차를 따라 후보를 넓게 만든 뒤, frame과 junction overlap 정보를 audit 열로 남깁니다.
4. peptide FASTA가 만들어졌을 때만 NetMHCpan 결과를 읽는다
섹션 제목: “4. peptide FASTA가 만들어졌을 때만 NetMHCpan 결과를 읽는다”원 논문은 NetMHCpan 4.0에 9-mer와 네 HLA allele을 넣었습니다.
HLA-A*01:01HLA-A*02:01HLA-A*03:01HLA-A*24:02
논문에서는 각 HLA에 대해 상위 0.5%에 해당하는 peptide를 potential strong binder로 정의했습니다. 이 값은 해당 논문의 후보 선택 규칙이며, 모든 버전과 모든 분석에 자동 적용되는 임상 threshold가 아닙니다.
다음 표는 열을 읽기 위한 가상 출력입니다.
| peptide | HLA | EL_Rank | BA_Rank | 이 실습의 분류 |
|---|---|---|---|---|
SLDVLKQMG | HLA-A*02:01 | 0.23 | 0.41 | paper-rule strong binder |
YLKQMGDVL | HLA-A*02:01 | 1.80 | 2.10 | 통과하지 않음 |
3단계 프롬프트: NetMHCpan output 감사
9-mer 후보의 NetMHCpan MHC-I 결합 결과를 감사해줘.

1. NetMHCpan의 로컬 실행 파일과 사용 조건을 확인해. 설치되어 있지 않으면 자동 다운로드나 라이선스 동의를 하지 말고 공식 서비스·academic download 위치를 안내한 뒤 입력 FASTA 준비 상태에서 멈춰.
2. 실행할 수 있다면 버전, 모델 mode, peptide length, allele 네 개와 전체 명령을 outputs/netmhcpan-run.txt에 기록해.
3. 원 논문 재현은 NetMHCpan 4.0 설정을 기준으로 하고, 현재 4.1을 사용했다면 EL·BA output 차이와 버전 차이를 결과에 명시해.
4. outputs/eocrc-splice-9mers.fasta를 네 HLA allele에 대해 실행하고 raw output을 수정하지 않은 채 보존해.
5. peptide, allele, EL score, EL rank, BA score, BA rank, predicted affinity와 binder level을 가능한 범위에서 파싱해 outputs/netmhcpan-parsed.tsv에 저장해.
6. 논문 절차와 비교할 때만 rank 상위 0.5% 규칙을 paper_strong_binder 열로 표시해. 도구의 현재 기본 SB/WB label과 섞지 마.
7. peptide provenance를 다시 join해 event ID, gene, frame과 junction_overlap을 보존해.
8. gene 수, event 수, strong-binder peptide 수를 계산하고 논문의 18개 gene, 그중 EOCRC 특이 event 7개라는 보고와 비교해. 다르면 숨기지 마.
9. MHC-I 결합 예측만으로 실제 발현, proteasomal processing, 세포막 제시와 T-cell 반응을 결론 내리지 말고 멈춰.5. 후보 표의 마지막 행까지 감사한다
섹션 제목: “5. 후보 표의 마지막 행까지 감사한다”최종 후보 한 행에는 최소한 다음 provenance가 남아야 합니다.
| 필드 | 확인할 내용 |
|---|---|
event_id | 어느 splicing event에서 시작했는가 |
coordinates, strand | 어떤 genomic block을 추출했는가 |
frame | 어느 reading frame을 번역했는가 |
peptide_start | amino-acid sequence의 어느 위치인가 |
junction_overlap | 9-mer가 새 junction을 실제로 가로지르는가 |
HLA | 어느 allele과 평가했는가 |
rank, tool_version | 어떤 모델과 기준으로 선별했는가 |
이 provenance가 끊기면 strong binder를 찾아도 그 peptide가 어느 event에서 나왔는지 재검증할 수 없습니다.
6. 결과를 보고 답할 질문
섹션 제목: “6. 결과를 보고 답할 질문”- BED에서 strand와 block 정보가 peptide를 바꾸는 이유는 무엇인가?
- 세 reading frame에서 나온 peptide를 모두 실제 단백질이라고 부를 수 없는 이유는 무엇인가?
- junction을 가로지르지 않는 flank-only 9-mer를 따로 표시해야 하는 이유는 무엇인가?
- percentile rank와 predicted affinity는 같은 값인가?
- strong MHC-I binder가 실제 neoantigen으로 확인되려면 무엇을 더 검증해야 하는가?
DNA 변이에서 9-mer를 만드는 다른 출발점은 Rosie PoC에서 비교할 수 있습니다. Rosie 실습은 DNA variant에서 시작하고, 이 실습은 RNA splicing event에서 시작하지만 peptide provenance를 보존해야 한다는 원칙은 같습니다.
7. 출처와 재현 정보
섹션 제목: “7. 출처와 재현 정보”재현 기록에는 reference FASTA, BED coordinate convention, flank 길이, strand·split 옵션, 번역 구현, peptide 길이, HLA allele, NetMHCpan 버전·mode·명령과 rank threshold를 남깁니다.