EOCRC 실습 4: exon과 splice junction 사용량 비교하기
1. 입력이 gene count에서 junction으로 바뀐다
섹션 제목: “1. 입력이 gene count에서 junction으로 바뀐다”HTSeq gene count의 한 행은 한 유전자의 여러 transcript를 합친 값입니다. 전체 HOTAIRM1 count가 같더라도 exon 2가 포함된 transcript와 빠진 transcript의 비율은 달라질 수 있습니다.
이 실습은 EOCRC 실습 1의 count 표를 재사용하지 않습니다. 대신 read가 어느 exon과 junction을 지지하는지 보존한 BAM과 event-level 결과표를 사용합니다.
| 입력 | 처리 | 출력 |
|---|---|---|
| BAM, GTF | rMATS | event별 inclusion·skipping count, PSI, FDR |
| FASTQ 또는 Whippet index | Whippet | node별 PSI, delta PSI, probability |
| 두 결과의 좌표 | coordinate matching | 두 도구가 공통 검출한 event |
2. rMATS 한 행을 읽는다
섹션 제목: “2. rMATS 한 행을 읽는다”다음은 skipped-exon 결과표를 단순화한 가상 예시입니다.
| gene | IJC_SAMPLE_1 | SJC_SAMPLE_1 | IncLevel1 | IncLevel2 | FDR | IncLevelDifference |
|---|---|---|---|---|---|---|
GENE_X | 41,38,45 | 9,12,8 | 0.81,0.76,0.83 | 0.34,0.39,0.31 | 0.002 | 0.45 |
IJC는 inclusion junction을 지지하는 read count이고 SJC는 skipping junction을 지지하는 read count입니다. IncLevel1과 IncLevel2는 각 그룹의 percent-spliced-in(PSI)입니다. IncLevelDifference는 rMATS에서 group 1 평균 PSI에서 group 2 평균 PSI를 뺀 값입니다.
PSI가 0.8이면 모든 세포의 transcript 80%에 exon이 들어 있다는 뜻은 아닙니다. 여러 세포와 transcript가 섞인 library에서 관측된 read evidence를 event-level inclusion 값으로 정규화한 결과입니다.
대표 event 다섯 종류
섹션 제목: “대표 event 다섯 종류”| rMATS 이름 | 질문 |
|---|---|
SE | 가운데 exon을 포함했는가, 건너뛰었는가? |
A5SS | 서로 다른 5′ splice site 중 어느 위치를 썼는가? |
A3SS | 서로 다른 3′ splice site 중 어느 위치를 썼는가? |
MXE | 두 exon 중 어느 하나를 선택했는가? |
RI | intron이 제거되지 않고 남았는가? |
3. 공개된 82개 최종 event를 감사한다
섹션 제목: “3. 공개된 82개 최종 event를 감사한다”원 논문은 rMATS에서 FDR < 0.05, |delta PSI| > 0.1, 종양 평균 coverage 20 초과를 사용했습니다. Whippet에서는 |delta PSI| > 0.1, probability > 0.7을 사용했고, 좌표가 일치하며 두 도구에서 모두 유의한 event 82개를 Supplementary Table S6에 공개했습니다.
하지만 공식 supplementary 파일에는 rMATS와 Whippet의 원본 event 표, 환자별 PSI, BAM이 없습니다. 따라서 공개 자료만으로 필터와 좌표 교집합을 처음부터 다시 계산할 수는 없습니다. 이 실습은 공개된 최종 82개를 감사하고, 원본 표가 필요한 지점에서 정확히 멈춥니다.
실행 프롬프트: Supplementary Table S6 감사
EOCRC 논문의 공개 alternative splicing 결과를 실제로 감사해줘.

1. Europe PMC의 PMC11047122 supplementaryFiles API에서 공식 ZIP을 내려받고 URL, 다운로드 날짜, 파일 크기와 SHA-256을 기록해.
2. ZIP의 DataSheet_1.docx를 python-docx로 열고 여섯 번째 표인 Supplementary Table S6를 읽어.
3. Gene name, Location, delta PSI, FDR, Event type 열을 원문 그대로 보존해 outputs/paper-table-s6-82-splicing-events.csv에 저장해.
4. 행 수가 82인지, Location이 chromosome:strand:start:end 형식으로 모두 파싱되는지, delta PSI와 FDR이 숫자인지 검증해.
5. event type별 개수, delta PSI가 양수와 음수인 event 수를 집계해.
6. delta PSI 대 -log10(FDR) 산점도와 event type 막대그래프를 만들어 outputs/splicing-event-landscape.png에 저장해.
7. HOTAIRM1 행의 좌표, strand, delta PSI, FDR, event type을 출력해.
8. supplementary ZIP 안에 rMATS·Whippet 원본 표나 환자별 PSI가 없으면 전체 교집합과 환자별 PSI를 만들지 말고, 빠진 입력을 명시한 뒤 멈춰.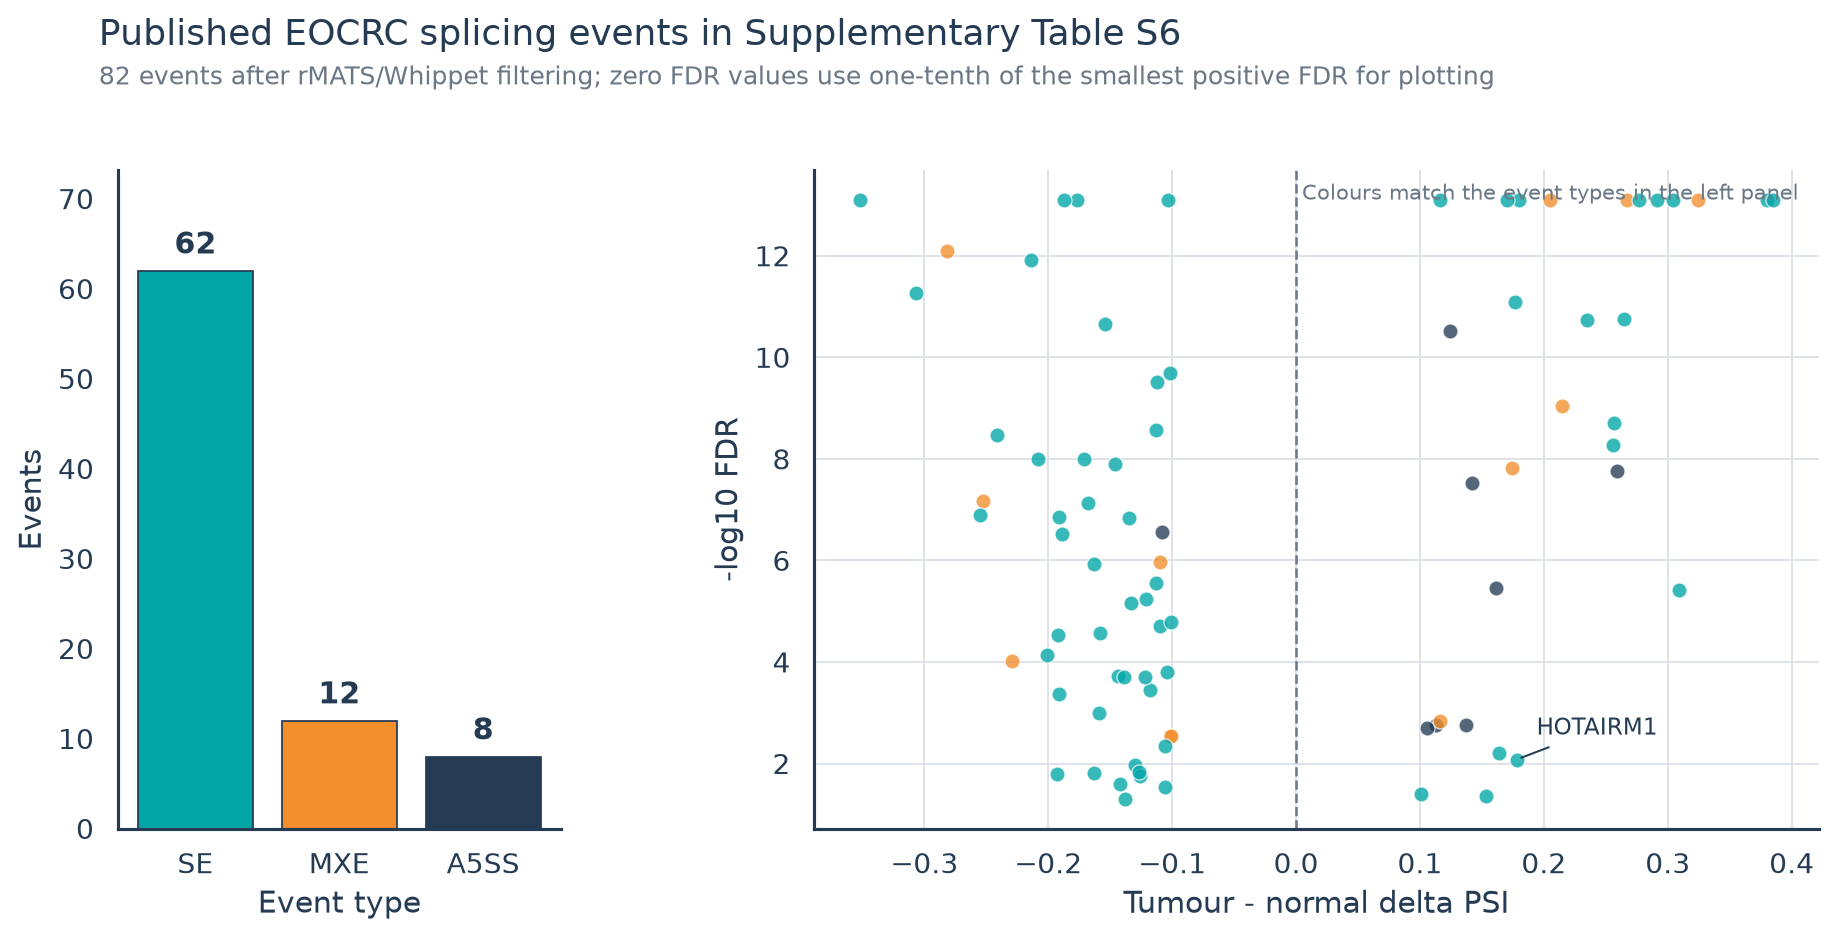
실제 실행 결과: 82개 중 SE 62개, MXE 12개, A5SS 8개였습니다. 종양에서 PSI가 증가한 event는 31개, 감소한 event는 51개였습니다. 색은 왼쪽 막대와 오른쪽 점에서 같은 event type을 나타냅니다.
두 도구의 교집합은 동일한 진실을 두 번 증명한 것이 아닙니다. rMATS와 Whippet은 event를 표현하고 정량화하는 단위가 다릅니다. 교집합을 사용하면 도구 한쪽의 표현과 threshold에만 의존한 후보를 줄일 수 있지만, 실제 transcript 구조를 확정하지는 못합니다.
4. HOTAIRM1 요약 행과 빠진 환자별 근거를 구분한다
섹션 제목: “4. HOTAIRM1 요약 행과 빠진 환자별 근거를 구분한다”원 논문은 EOCRC 종양에서 HOTAIRM1 exon 2 inclusion이 높고 EOCRC 정상에서는 낮은 event를 대표 사례로 제시했습니다. LOCRC에서는 exon 2 inclusion이 전반적으로 매우 낮았습니다.
확장 프롬프트: 원본 입력이 있을 때만 환자별 HOTAIRM1 확인
Supplementary Table S6에서 HOTAIRM1 요약 행을 먼저 확인해줘.

1. HOTAIRM1의 공개 값인 chr7, + strand, 27099097:27099366, delta PSI 0.178, FDR 0.00834, SE를 출력해.
2. 이 한 행은 환자별 PSI나 junction count가 아니라 그룹 비교 요약임을 기록해.
3. 환자별 rMATS 결과 또는 BAM과 index가 별도로 제공됐을 때만 patient-condition long table, paired PSI plot, Sashimi plot을 만들어.
4. 해당 입력이 없으면 Figure 4G를 데이터에서 역으로 추정하거나 점을 꾸며내지 말고 필요한 파일 목록을 출력한 뒤 멈춰.
Sashimi plot에서 exon 위의 높이는 coverage이고, exon 사이 arc는 junction을 지지하는 read를 나타냅니다. PSI는 여러 junction count를 하나의 inclusion 값으로 요약하므로, 같은 PSI라도 read depth와 junction 조합은 다를 수 있습니다.
5. 결과를 보고 답할 질문
섹션 제목: “5. 결과를 보고 답할 질문”- gene count 한 행에서 exon inclusion을 복원할 수 없는 이유는 무엇인가?
IncLevelDifference=0.2는 무엇을 뺀 값인가?- FDR이 작아도 coverage 필터가 필요한 이유는 무엇인가?
- rMATS와 Whippet 좌표를 그대로 문자열 join하면 안 되는 이유는 무엇인가?
- 두 도구의 공통 event가 실제 단백질 isoform을 확정하지 못하는 이유는 무엇인가?
다음 EOCRC 실습 5에서는 종양에서 증가한 splicing event의 nucleotide sequence를 추출하고 9-mer peptide와 MHC-I 결합 후보로 변환합니다.
6. 출처와 재현 정보
섹션 제목: “6. 출처와 재현 정보”재현 기록에는 genome build, GTF, read length, library type, rMATS·Whippet 버전, event filter, coordinate 변환, BAM 병합 여부와 sample 순서를 남깁니다.